هر بار که یک مدل عمومی روی متن فارسی نتیجهٔ ضعیفی میدهد، جواب ساده این است که دادهٔ فارسی کم است. این درست است اما همهٔ ماجرا نیست. پردازش زبان فارسی چند ویژگی ساختاری دارد که حتی با دادهٔ فراوان هم کار را سخت میکند. این راهنما هفت ویژگی را یکییکی باز میکند و میگوید هرکدام در عمل چه خطایی تولید میکنند.
چقدر دادهٔ آموزشی فارسی در دسترس است؟
برای مقایسهٔ عددی، پیکرهٔ Common Voice موزیلا یکی از معدود منابع عمومی گفتار است. در نسخهٔ ۲۵، فارسی حدود ۳۷۳ ساعت گفتار تأییدشده از ۴٬۶۵۵ گوینده دارد، در حالی که انگلیسی نزدیک به ۲٬۷۸۵ ساعت تأییدشده ثبت کرده است.
این اختلاف حدود هفتبرابری فقط در یک منبع است و در دادهٔ متنی هم الگوی مشابهی دیده میشود. کمبود داده نقطهٔ شروع مسئله است، نه پایان آن.
ویژگی اول: مرز کلمه در فارسی قطعی نیست
در انگلیسی، فاصله یعنی مرز کلمه. در فارسی اینطور نیست. «میرود» یک کلمه است که با نیمفاصله نوشته میشود و همان کلمه را افراد به سه شکل مینویسند، یعنی «میرود»، «می رود» و «میرود». برای مدلی که کلمهها را به قطعه میشکند، این سه شکل سه چیز متفاوتاند.
اثرش در آرشیو جلسات دیده میشود، چون جستوجوی «میرود» متنی را که «میرود» نوشته شده پیدا نمیکند. راهحل، عادیسازی صریح متن پیش از ذخیره و پیش از جستوجوست.
ویژگی دوم: یک حرف با چند کدنقطه
«ی» فارسی و «ي» عربی دو کاراکتر با دو کد متفاوتاند که تقریباً یکسان دیده میشوند. همین وضعیت برای «ک» و «ك» هم وجود دارد. صفحهکلیدهای مختلف و کپیکردن از منابع گوناگون، هر دو نسخه را وارد داده میکنند.
نتیجه این است که دو رشته که چشم انسان یکسان میبیند، برای ماشین نابرابرند. این یکی از رایجترین دلایل کار نکردن جستوجو در سیستمهای فارسی است.
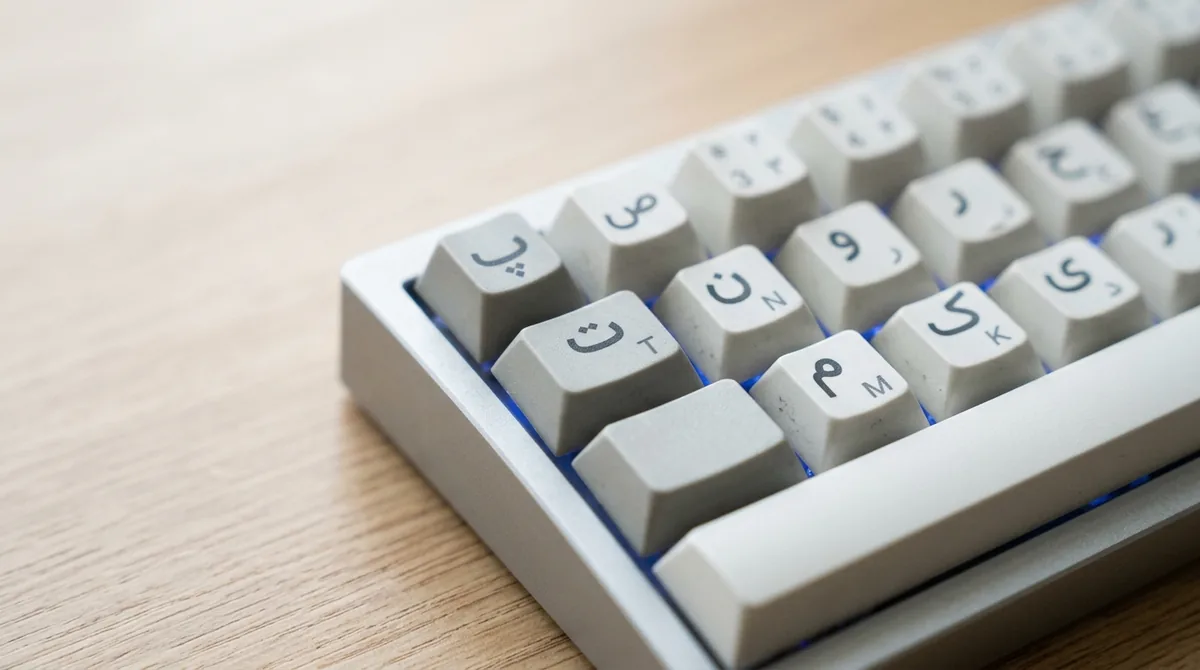
حرفهایی که چشم انسان یکسان میبیند، برای ماشین دو کاراکتر متفاوتاند.
ویژگی سوم: مصوتهای کوتاه نوشته نمیشوند
فارسی اعراب را نمینویسد. واژهٔ «کرم» بدون اعراب میتواند سه معنای متفاوت داشته باشد و انسان از بافت جمله تشخیص میدهد. مدل هم باید همین کار را بکند، اما به بافت بیشتری نیاز دارد و در جملههای کوتاه که در جلسه فراواناند، بافت کافی وجود ندارد.
ویژگی چهارم: جملهٔ دوزبانه حالت عادی است
جملهای مثل «این فیچر را تا اسپرینت بعد دیپلوی میکنیم، ولی باید قبلش ریویو بشود» در جلسههای فنی ایران روزمره است و نسخهٔ نوشتاریاش معمولاً واژههای انگلیسی را با الفبای لاتین دارد.
برای مدلی که آموزش دیده یا فارسی بنویسد یا انگلیسی، این جمله چالشبرانگیز است، چون باید وسط جمله جهت نوشتن، الفبا و واژگان را عوض کند و برگردد. مدلهایی که فقط روی فارسی خالص آموزش دیدهاند، واژهٔ انگلیسی را حدس میزنند و چیزی میسازند که در گفتار اصلی نبوده است.
ویژگی پنجم: فاصلهٔ زبان گفتار با زبان نوشتار
بخش عمدهٔ متن فارسی موجود روی اینترنت، فارسی کتابی است؛ خبر، مقاله و دانشنامه. اما جلسه با فارسی محاورهای برگزار میشود و «میخواهم بروم» در گفتار میشود «میخوام برم». این دو ساختار واجی متفاوتی دارند و مدلی که بیشتر متن کتابی دیده، محاوره را ضعیفتر میفهمد.
به این، تنوع لهجهها را اضافه کنید و اینکه یک جلسهٔ دهنفره ممکن است چند لهجهٔ متفاوت داشته باشد.
ویژگی ششم: اسمهای خاص فارسی
نام افراد ایرانی، شرکتها، محصولات داخلی و شهرها در دادهٔ آموزشی مدلهای چندزبانه سهم ناچیزی دارند. مدل وقتی اسمی را نمیشناسد، نزدیکترین واژهٔ آشنا را جایگزین میکند.
در تحلیل جلسه، این خطا از بقیه گرانتر است. اگر نام یک فرد اشتباه نوشته شود، کاری که قرار بود به او نسبت داده شود بیصاحب میماند و یک خطای رونویسی به یک خطای مدیریتی تبدیل میشود.
ویژگی هفتم: راستبهچپ بودن
این مورد تا وقتی مسئلهٔ ظاهری به نظر میرسد که خروجی را در یک سند یا ابزار مدیریت کار بریزید و ترتیب کلمهها به هم بریزد، مخصوصاً وقتی عدد، تاریخ و واژهٔ انگلیسی در یک جمله کنار هم باشند. جهتدهی درست باید در تمام مسیر داده رعایت شود، نه فقط در نمایش نهایی.
خلاصهٔ هفت ویژگی و خطایی که تولید میکنند
| ویژگی | خطای عملی | راهحل |
|---|---|---|
| نیمفاصله و مرز کلمه | جستوجو نتیجه نمیدهد | عادیسازی پیش از ذخیره و جستوجو |
| حروف عربی و فارسی همشکل | دو رشتهٔ ظاهراً یکسان نابرابر میشوند | یکسانسازی کاراکترها |
| نبود اعراب | خواندن اشتباه واژههای همنگاشت | استفاده از بافت جمله و واژهنامهٔ حوزه |
| جملهٔ دوزبانه | ساخت واژهٔ فارسی بهجای اصطلاح انگلیسی | مدیریت جداگانهٔ واژهٔ خارجی |
| محاوره در برابر کتابی | افت دقت روی گفتار واقعی جلسه | آموزش روی دادهٔ گفتاری واقعی |
| اسم خاص | کار بیصاحب در خروجی | واژهنامهٔ اسامی تیم |
| راستبهچپ | بههمریختگی ترتیب در خروجی | رعایت جهت در کل مسیر داده |
تفاوت سرویس چندزبانه با سرویس ساختهشده برای فارسی چیست؟
هیچکدام از این هفت مورد غیرقابلحل نیست، اما هیچکدام هم خودبهخود حل نمیشود. کاری که باید انجام شود مشخص است. عادیسازی صریح متن، آموزش روی دادهٔ گفتاری واقعی فارسی، مدیریت جداگانهٔ واژههای خارجی و واژهنامهٔ اسمهای خاص که با نام اعضای تیم پر شود.
این همان تفاوت میان سرویسی است که فارسی را هم پشتیبانی میکند و سرویسی که برای فارسی ساخته شده است. اثر مستقیم این تفاوت روی کیفیت تحلیل هوشمند جلسات دیده میشود، چون تحلیل روی همان متن خروجی ساخته میشود.
در سالهای اخیر چه چیزی بهتر شده است؟
تصویر کلی بهتر از چند سال پیش است. مدلهای چندزبانهٔ جدید نسبت به نسل قبل، فارسی را با خطای کمتری رونویسی میکنند و پیکرههای عمومی فارسی هم بهآرامی بزرگتر شدهاند. تنظیمکردن مدلهای باز روی دادهٔ فارسی هم رایجتر شده و نتیجهاش را میشود در مدلهای منتشرشده روی مخازن عمومی دید.
چیزی که تغییر نکرده، ویژگیهای ساختاری زبان است. نیمفاصله، حروف همشکل و جملهٔ دوزبانه با بزرگتر شدن مدل حل نمیشوند و همچنان به پردازش صریح نیاز دارند.
برای دادهٔ فارسی سازمان خودتان چه کنید؟
سه کار عملی که هر تیمی میتواند انجام دهد و اثرش فوری است:
- واژهنامهٔ اسامی بسازید: نام اعضای تیم، محصولات و مشتریان اصلی. این فهرست بیشترین اثر را در کاهش خطای خروجی دارد.
- اصطلاحات تخصصی را ثبت کنید: واژههایی که در صنعت شما معنای خاص دارند یا مخففاند.
- یک قاعدهٔ نوشتاری انتخاب کنید: اینکه اصطلاح انگلیسی با الفبای لاتین نوشته شود یا فارسی، باید یکسان باشد تا جستوجو در آرشیو نتیجه بدهد.
جمعبندی
اگر میخواهید یک سرویس را برای فارسی ارزیابی کنید، این آزمون ساده را اجرا کنید. یک فایل دهدقیقهای از یک جلسهٔ واقعی با چند گوینده، چند اسم خاص و چند واژهٔ انگلیسی بدهید و خروجی را روی همین هفت مورد بررسی کنید. مسیر فنی از صدا تا متن در تبدیل گفتار به متن فارسی آمده است.
سؤالات متداول
چرا مدلهای بزرگ چندزبانه روی فارسی ضعیفترند؟
سهم فارسی در دادهٔ آموزشی آنها کم است و ویژگیهای ساختاری مانند نیمفاصله و نبود اعراب به پردازش اختصاصی نیاز دارند که در یک مدل عمومی انجام نمیشود.
نیمفاصله واقعاً چقدر اهمیت دارد؟
در نمایش، تفاوتش ظاهری به نظر میرسد. در جستوجو و تطبیق متن، تفاوت میان پیدا شدن و پیدا نشدن یک جلسه است. برای همین باید پیش از ذخیرهسازی عادیسازی انجام شود.
آیا افزودن اسامی تیم به سیستم دقت را بالا میبرد؟
بله و معمولاً بیشترین بهبود قابلمشاهده را ایجاد میکند، چون اسمهای خاص پرخطاترین بخش خروجیاند و خطایشان مستقیم روی نسبتدادن کارها اثر میگذارد.
فارسی محاورهای را میشود به فارسی کتابی تبدیل کرد؟
تا حدی، اما این تبدیل خودش منبع خطاست و بهتر است خروجی به همان شکل گفتاری حفظ شود و فقط برای اسناد رسمی بازنویسی شود.
برای متن فارسی چه عادیسازیهایی لازم است؟
حداقل سه مورد. یکسانسازی «ی» و «ک»، اصلاح نیمفاصله در فعلها و پیشوندها، و یکدستکردن ارقام فارسی و لاتین. این سه، بیشتر خطاهای جستوجو را برطرف میکند.