هر سرویس رونویسی یک عدد دقت اعلام میکند و تقریباً هیچکدام نمیگوید آن عدد روی چه دادهای و با چه روشی به دست آمده است. بدون این دو، عدد قابل استفاده نیست. این راهنما توضیح میدهد دقت رونویسی با چه معیاری سنجیده میشود، چرا محاسبهٔ خام آن در فارسی نتیجهٔ غلط میدهد و چه معیارهایی در کنار آن لازم است.
نرخ خطای واژه یا WER چیست؟
استاندارد رایج سنجش، نرخ خطای واژه است که به اختصار WER نامیده میشود. کار آن ساده است. متن تولیدشده را با متن مرجع انسانی مقایسه میکند و میشمارد چند واژه باید جایگزین، حذف یا اضافه شود تا به مرجع برسیم. این عدد تقسیم بر تعداد کل واژههای مرجع، WER را میدهد.
WER پایینتر بهتر است. مقدار ۱۰ درصد یعنی از هر ده واژه، یکی خطا دارد. نکتهٔ مهم این است که این عدد بدون ذکر مجموعهٔ آزمون معنا ندارد. مدلهای تنظیمشدهٔ فارسی که روی Hugging Face منتشر شدهاند، بسته به دادهٔ آزمون WER بین حدود ۸ تا ۳۹ درصد گزارش کردهاند.
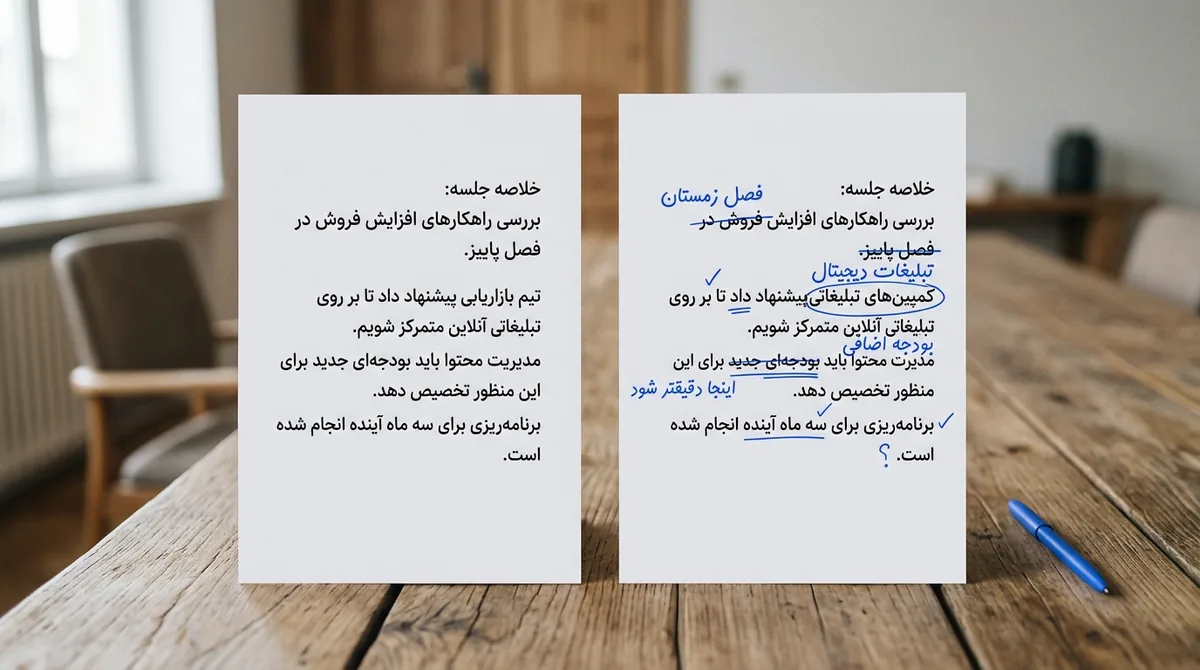
سنجش دقت یعنی مقایسهٔ واژهبهواژهٔ خروجی با متن مرجع انسانی.
چرا WER خام در فارسی عدد غلط میدهد؟
اگر WER را بدون آمادهسازی روی فارسی حساب کنید، نتیجه معمولاً بدتر از واقعیت درمیآید. سه دلیل اصلی دارد:
- نیمفاصله: «میرود» در مرجع و «می رود» در خروجی، خطای واقعی نیست ولی WER خام آن را دو خطا میشمارد، یک حذف و یک اضافه.
- حروف همشکل: «ی» و «ک» فارسی در برابر «ي» و «ك» عربی، کاراکترهای متفاوتی با ظاهر یکساناند و بدون یکسانسازی خطا شمرده میشوند.
- شکل عدد: «۲۳» در برابر «بیست و سه». کدام درست است به کاربرد بستگی دارد و باید پیش از سنجش دربارهٔ آن تصمیم گرفت.
بنابراین پیش از هر مقایسه، هر دو متن باید عادیسازی شوند. اگر سرویسی عدد اعلام میکند ولی نمیگوید چه عادیسازیای انجام داده، عددش با عدد سرویس دیگر قابل مقایسه نیست. ریشهٔ این پیچیدگیها را در چرا پردازش زبان فارسی سخت است باز کردهایم.
دادهٔ آزمون باید چه ویژگیهایی داشته باشد؟
سادهترین راه رسیدن به عدد دقت خیرهکننده، انتخاب دادهٔ آسان است. یک گوینده، اتاق بیپژواک، فارسی کتابی و متن از پیش آماده. روی چنین دادهای تقریباً هر مدلی خوب عمل میکند و عدد بهدستآمده دربارهٔ جلسهٔ واقعی چیزی نمیگوید.
مجموعهٔ آزمونی که به جلسهٔ واقعی نزدیک است باید این ویژگیها را داشته باشد:
- چند گوینده: با بازههای همپوشانی گفتار.
- کیفیت صدای متفاوت: یکی با هدست و یکی با میکروفون دور.
- فارسی محاورهای: نه متن کتابی خواندهشده.
- واژههای انگلیسی: در میان جملهٔ فارسی.
- اسمهای خاص فارسی: نام افراد و شرکتها.
- صدای پسزمینه: تایپ، باز و بسته شدن در، صدای خیابان.
چرا یک عدد کافی نیست؟
WER کلی، همهٔ خطاها را یکسان وزن میدهد. اما در تحلیل جلسه همهٔ خطاها ارزش یکسانی ندارند. اشتباه نوشتن حرف ربط تقریباً بیاثر است، ولی اشتباه نوشتن نام یک نفر یعنی کاری که به هیچکس نسبت داده نمیشود.
| معیار | چه چیزی را میسنجد | چرا مهم است |
|---|---|---|
| WER کلی | خطای کلی واژهها | مقایسهٔ کلی کیفیت رونویسی |
| دقت اسم خاص | نام افراد و شرکتها | نسبتدادن درست کارها به افراد |
| دقت عدد و تاریخ | ارقام و مهلتها | استخراج درست ددلاینها |
| دقت تفکیک گوینده | نسبت زمانی که به گویندهٔ درست نسبت داده شده | اعتبار نقلقولها |
| دقت خروجی نهایی | چند کار از فهرست تولیدشده واقعاً در جلسه تعهد شده بود | همان چیزی که کاربر تجربه میکند |
معیار آخر از همه مهمتر است. رونویسی با WER خوب که کارها را اشتباه بیرون بکشد، برای کاربر یعنی سیستم خراب.
محدودیتهایی که پنهان نمیکنیم
هیچ سیستمی در همهٔ شرایط یکسان عمل نمیکند. جاهایی که ما هم افت دقت داریم مشخص است. صدای بسیار دور از میکروفون، سه نفر که همزمان حرف میزنند، لهجهٔ غلیظی که در دادهٔ آموزشی کمنماینده است، و اصطلاحات بسیار تخصصی یک صنعت خاص.
اعلام این محدودیتها بخشی از صادقبودن دربارهٔ محصول است. عدد دقت بدون ذکر شرایط، بیشتر ادعای بازاریابی است تا اطلاعات فنی.
چطور دقت یک سرویس را خودتان بسنجید؟
- یک فایل واقعی انتخاب کنید: ده دقیقه از یک جلسهٔ معمولی تیم، نه نمونهٔ تمیز.
- متن مرجع بسازید: همان ده دقیقه را یک نفر دقیق پیاده کند.
- هر دو متن را عادیسازی کنید: نیمفاصله، حروف همشکل و شکل اعداد.
- جداگانه بشمارید: خطای اسمهای خاص و خطای تاریخها را از خطای کلی جدا کنید.
- خروجی نهایی را بسنجید: فهرست کارهای تولیدشده را با آنچه واقعاً در جلسه تعهد شد مقایسه کنید.
چرا دقت اعلامشده با تجربهٔ کاربر فرق دارد؟
سه دلیل ساختاری وجود دارد. اول اینکه دادهٔ آزمون سرویسها معمولاً تمیزتر از جلسهٔ واقعی است. دوم اینکه کاربر خطاها را یکسان نمیبیند؛ یک اسم اشتباه بیشتر از ده حرف ربط اشتباه به چشم میآید. سوم اینکه کاربر خروجی نهایی را قضاوت میکند، نه متن خام رونویسی را.
به همین دلیل، سنجش کیفیت باید روی همان چیزی انجام شود که کاربر میبیند. فهرست کارها، تصمیمها و نسبتدادن درست جملهها به افراد.
چطور دقت را در طول زمان پایش کنیم؟
یک روش سبک که برای تیمها عملی است، انتخاب یک جلسهٔ نمونه در ماه و مقایسهٔ خروجی با بازبینی انسانی همان جلسه است. سه عدد را ثبت کنید:
- تعداد کارهای جاافتاده: کارهایی که در جلسه تعهد شدند و در خروجی نیستند.
- تعداد کارهای اضافه: مواردی که در خروجی آمدهاند ولی تعهد نبودهاند.
- تعداد اسمهای اشتباه: نام افراد یا شرکتهایی که غلط نوشته شدهاند.
روند این سه عدد در چند ماه، تصویر دقیقتری از کیفیت میدهد تا هر عدد اعلامشدهای. اگر عدد سوم بالا بود، پیش از هر اقدام دیگری واژهنامهٔ اسامی تیم را کامل کنید.
جمعبندی
پیش از باور کردن عدد دقت یک سرویس، دو سؤال بپرسید. روی چه دادهای سنجیده شده و چه عادیسازیای انجام شده است. اگر جواب مشخصی وجود ندارد، خودتان با یک فایل دهدقیقهای آزمون بگیرید. مسیر فنی از صدا تا متن در تبدیل گفتار به متن فارسی توضیح داده شده است.
سؤالات متداول
WER خوب برای فارسی چند است؟
عدد مطلق بدون ذکر دادهٔ آزمون معنا ندارد. روی گفتار تمیز و تکگوینده اعداد تکرقمی گزارش شده و روی جلسهٔ چندنفره با صدای محیط، همان مدلها عدد بسیار بالاتری میگیرند.
تفاوت WER با CER چیست؟
WER خطا را در سطح واژه میشمارد و CER در سطح کاراکتر. برای فارسی که مرز واژهها قطعی نیست، CER گاهی تصویر منصفانهتری میدهد، اما WER چیزی است که تجربهٔ کاربر را بهتر نشان میدهد.
چرا دقت روی جلسهٔ ما کمتر از عدد اعلامشده است؟
معمولاً بهدلیل تفاوت شرایط. تعداد گویندگان، فاصله از میکروفون، صدای محیط و وجود اصطلاحات تخصصی، همگی دقت را نسبت به دادهٔ آزمون استاندارد کاهش میدهند.
دقت تفکیک گوینده چطور سنجیده میشود؟
با سنجش نسبت زمانی که به گویندهٔ درست نسبت داده شده است. خطای رایج در بازههای همپوشانی و در گویندگانی رخ میدهد که از یک میکروفون مشترک استفاده میکنند.
آیا بهبود کیفیت ضبط بیشتر از تغییر سرویس اثر دارد؟
در بیشتر موارد بله. فاصلهٔ میکروفون و پژواک اتاق، بیشترین تأثیر را بر خطا دارند و اصلاحشان معمولاً ارزانتر از مهاجرت به سرویس دیگر است.